Почему всё делает браузер
Стат.Свод — сервис для продавцов Wildberries. Он берёт еженедельный отчёт о реализации и показывает, сколько принёс каждый товар после закупки. Главное условие продукта: не просить API-ключ от кабинета. Ключ открывает доступ к деньгам и данным магазина, и многие продавцы отдавать его не готовы.
Без ключа остаётся один путь. Продавец сам скачивает отчёт и перетаскивает файл на страницу. А раз сервис обещает, что данные магазина никуда не уходят, файл должен разбирать браузер.
Из этого обещания выросли все задачи этой статьи:
- прочитать Excel на 400 тысяч строк на обычном ноутбуке за секунды;
- не утонуть в памяти, когда распакованный лист весит гигабайт;
- посчитать деньги до копейки и доказать, что ничего не потерялось;
- хранить закупочные цены на сервере так, чтобы сам сервер не мог их прочитать.
Ниже — что оказалось самым трудным и как я это решил. Стек обычный: Angular на фронте, Fastify и SQLite на бэкенде. Интересное происходит не в нём, а в штатных API браузера.
Вызов 1. Гигабайт XML в одной вкладке
Недельный отчёт крупного продавца — это до 400 тысяч строк и около 130 МБ на диске. XLSX — это zip-архив с XML внутри, и в распакованном виде лист такого отчёта весит около гигабайта.
Первая мысль — взять готовую библиотеку. Но популярные библиотеки распаковывают лист в память целиком, и на таком файле вкладка упирается в предел длины строки V8. Парсер на Rust и wasm я тоже рассматривал и отказался: второй язык и вторая сборка ради одной функции.
В итоге парсер свой, на штатных API браузера, и файл ни в один момент не лежит в памяти целиком:
- Файл читается кусками.
File из зоны перетаскивания — это Blob. Его можно резать через slice и читать с диска по мере надобности. - Размеры берутся из оглавления архива. В конце zip лежит центральный каталог: список файлов с размерами и смещениями. Доверять нужно именно ему. Отчёты WB собираются потоком, и в локальных заголовках файлов вместо размеров стоят нули: настоящие дописываются уже после данных.
- Распаковка идёт потоком. В zip лежит сырой deflate без zlib-обёртки, поэтому нужен
DecompressionStream('deflate-raw'). Вариант 'deflate' ждёт zlib-заголовок, которого там нет, и падает на первом же байте. - XML разбирается на лету. Каждая строка сразу сворачивается в суммы по товару и выбрасывается.
Всё это работает в Web Worker. Дело не только в том, чтобы интерфейс не зависал. Вся память разбора живёт внутри воркера, а главный поток получает только итог: тысячи записей по товарам вместо сотен тысяч строк. После ответа воркер закрывают, и память освобождается разом. Тот же terminate служит отменой. Сам файл передаётся в воркер ссылкой: структурное клонирование байты File не копирует.
Чего в парсере нет намеренно. Zip64 распознаётся и отвергается с понятной ошибкой: до его предела в 4 ГиБ далеко. CRC32 не проверяется: встроенной реализации в браузере нет, а повреждённый файл и так сломает распаковку.
Вызов 2. Таблица, которую нельзя поднимать в память
Потоковое чтение решает проблему листа, но не всю. В xlsx текст обычно не лежит в ячейке. Ячейка хранит номер, а сам текст лежит в отдельном файле архива, таблице общих строк. Обычно её читают целиком в массив и потом подставляют текст по номерам.
У отчёта WB эта таблица на 400 тысяч строк весит 74 МБ. Причина в колонках, уникальных для каждой строки: «Srid», «Стикер МП», «Код маркировки». Таблица растёт вместе с файлом, а нам из неё нужны несколько тысяч значений: баркоды, размеры, артикулы и типы операций.
И тут получается замкнутый круг. Чтобы понять, какая колонка денежная, нужна шапка. Шапка — это тоже номера в таблице общих строк. Значит, сначала нужна таблица, а чтобы взять из неё только нужное, сначала нужно знать, какие номера искать.
Круг разорвался четырьмя проходами:
- Первая строка листа. Она стоит первой, и для неё достаточно распаковать десяток килобайт. На выходе номера ячеек шапки.
- Таблица строк. Из неё берём текст шапки и номера восемнадцати типов операций. Их узнаём по тексту: баркод не может совпасть со словом «Продажа».
- Весь лист. Строки сворачиваются в суммы по товарам, но баркод, размер и артикул остаются номерами. Целое число отлично работает ключом
Map. Два разных номера не могут оказаться одним баркодом, потому что таблица общих строк без повторов по построению. - Таблица строк ещё раз. Теперь из неё берём только те несколько тысяч значений, которые стали ключами, и переименовываем ключи в текст.
Лист читается один раз, таблица строк дважды. Это дешёвая половина: таблица в одиннадцать раз меньше листа.
Результат в цифрах. 400 тысяч строк разбираются за 4,2–5 секунд, скорость ровная, около 230 МБ XML в секунду. После сборки мусора от разбора остаётся 5,8 МБ против 5,4 МБ на 100 тысячах: файл вчетверо больше стоит 0,4 МБ.
Но замеры принесли и сюрприз. Пиковая память зависит не от размера файла, а от числа товаров у продавца. На тех же 400 тысячах строк это 79 МБ при 300 товарах, 95 МБ при 5000 и 112 МБ при 10 000. Свой бюджет в 100 МБ парсер держит примерно до 5000 товаров. Увидеть это можно было только на тестовом файле с широким каталогом: на обычном, с 300 товарами, всё выглядело прекрасно.
Вызов 3. Живой отчёт не похож на документацию
У WB есть официальное описание отчёта: 84 колонки и их смысл. Настоящий файл от него отличается, и каждое отличие ломало что-нибудь своё.
Заголовки написаны по-другому. В файле «реализовал Товар» с заглавной, «Сумма удержанная» без запятой. Строгое сравнение упало бы на первом же файле. Поэтому заголовки сравниваются после нормализации: регистр, «ё», запятые, точки и лишние пробелы не влияют. Из 84 колонок нужны 23, остальные парсер пропускает, не читая значение.
Пустые ячейки не записаны вовсе. В строке остаются дырки, и разбор по порядку съехал бы на первой же. Номер колонки берётся из адреса ячейки, атрибута r.
Часть сумм записана текстом. В некоторых строках деньги лежат не числом, а строкой вида 1234,56. Excel такие ячейки в СУММ не берёт, и парсер, повторяющий Excel, потерял бы эти деньги. Хуже другое: текст в xlsx лежит в таблице общих строк. В третьем проходе такая сумма приходит номером, и посчитать её нельзя.
Первая идея — заранее забрать из таблицы всё, что похоже на число. Не работает: «Стикер МП» состоит из одних цифр, «Srid» — из цифр с точками. Фильтр по форме утащил бы сотни тысяч значений, и память снова поплыла бы.
Решение — отложенные деньги. Строка с текстовой суммой целиком откладывается в список. После четвёртого прохода номера становятся текстом, и такие строки досчитываются. Сложение не зависит от порядка, так что итог не меняется. Таких строк около трёх процентов.
Встречаются незнакомые типы операций. У каждой строки есть «Обоснование для оплаты»: продажа, возврат, логистика, штраф и так далее, всего восемнадцать. По нему парсер решает, в какую колонку смотреть и куда сложить деньги. WB может добавить девятнадцатый тип в любой день. Сначала такая строка роняла весь разбор, и перед запуском я это поменял. Теперь незнакомое обоснование в деньги не идёт, но считается и дословно печатается на дашборде рядом с итогом. Продавец видит, что именно не посчитано, а я узнаю о новом типе до того, как до меня дойдёт жалоба.
Вызов 4. Деньги до копейки
Продавец обязательно сравнит наш итог с суммой в кабинете. Если они разойдутся хотя бы на рубль, доверия к остальным цифрам уже не будет.
Все суммы хранятся в целых копейках. Если складывать числа с плавающей точкой, на четырёхстах тысячах слагаемых накапливается погрешность, и сверка начинает врать на ровном месте.
Прибыль считается от суммы «к перечислению». Это деньги, которые WB реально отдаст. Прибыль = к перечислению − закупка. Можно было бы сложить выручку и вычесть расходы по колонкам, но тогда любое удержание, которого я не предусмотрел, молча пропало бы. Поэтому в расчёте есть строка «прочее». Это остаток тождества «выручка − вознаграждение WB = к перечислению». В норме там ноль, а всё, что WB удержал сверх названного, всплывает именно в ней.
Итог проверяется тремя независимыми путями. Строки «итого» в отчёте нет, WB её не пишет, так что свериться с самим файлом нельзя. Зато к одному и тому же числу можно прийти тремя дорогами:
- Сумма по товарам плюс расходы, не привязанные к товару, дают итог отчёта.
- Итог по типам операций, со знаками, сходится с итогом по статьям расходов.
- Выручка минус все статьи складывается в «к перечислению».
Если все три сошлись до копейки, по дороге ничего не потерялось и не посчиталось дважды. Если нет, продавец видит предупреждение с суммой расхождения, а не просто «что-то не так». Последнюю сверку делает сам продавец, глазами, поэтому итог стоит на дашборде крупно.
Несколько решений вокруг этого числа оказались не техническими, а продуктовыми:
- Себестоимость берётся на дату продажи. Закупочная цена меняется от партии к партии, и недельный отчёт может застать обе. Для этого парсер раскладывает проданные штуки по дням.
- Товар без цены хотя бы на один день не считается вовсе. Наполовину посчитанная прибыль выглядит на дашборде так же уверенно, как настоящая. Вместо неё продавец видит подсказку, на какую дату добавить цену.
- Расходы без привязки к товару не разносятся. Хранение и удержания без баркода вычитаются одной строкой в итоге. Если разнести их пропорционально выручке, залежавшийся на складе товар получит копейки хранения, а основную долю заберёт бестселлер. Цифра появится, а смысла в ней не будет.
- Это прибыль до налога и рекламы, и так она и называется. Ни того, ни другого в отчёте нет. Назови я её «чистой», продавец сверил бы её с цифрой бухгалтера и решил, что сервис ошибается на четверть.
Вызов 5. Сервер, который не может прочитать цены
Отчёт остаётся в браузере, а вот справочник себестоимости должен жить на сервере. Иначе его придётся заново вводить на каждом устройстве. Но закупочные цены — коммерческая тайна, и обещание «мы не смотрим» стоит немного. Нужно было сделать так, чтобы сервер не мог их прочитать, даже если база утечёт целиком.
Два ключа из одного пароля. Браузер прогоняет пароль через PBKDF2 на 600 000 итераций, а потом дважды через HKDF с разными метками. Первый выход — ключ шифрования, он никогда не покидает браузер. Второй — доказательство входа, оно уходит на сервер вместо пароля. HKDF односторонний: по доказательству ключ не восстановить. Второй прогон PBKDF2 стоил бы вдвое дороже и ничего не дал бы.
На сервере доказательство тоже не хранится как есть. В базе лежит его scrypt-хеш со своей солью, с параметрами из рекомендаций OWASP. Argon2id стойче, но тянет нативную сборку, а scrypt есть в node:crypto из коробки.
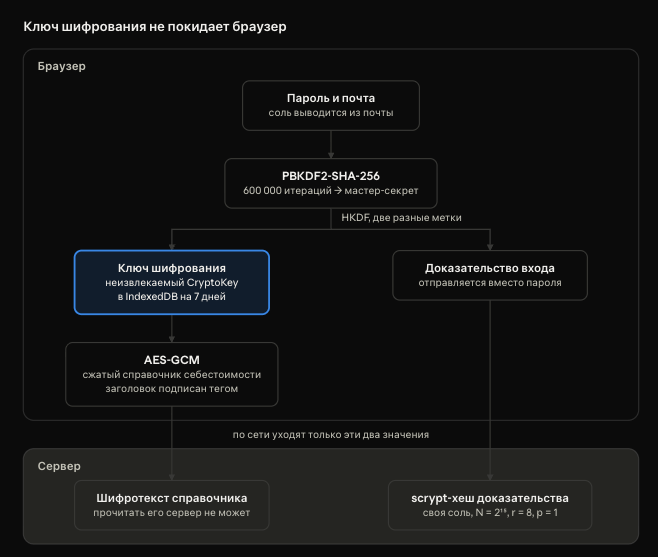
Ключ шифрования живёт только в браузере. Сервер получает доказательство входа и хранит его хеш, а справочник видит только в виде шифротекста.
Соль выводится из почты. Это самое неочевидное решение. Обычно соль случайная и хранится на сервере. Но тогда браузеру пришлось бы спросить её до входа, и сервер подтверждал бы существование аккаунта любому, кто угадал адрес. Соль из почты всё равно у каждого своя, так что радужные таблицы не помогают. По той же причине параметры вывода одни на всё приложение и версионируются: спросить сервер «какие параметры у этого аккаунта» нельзя.
Из этого само собой следует вход с другого устройства. Ключ нигде не хранится, он заново вычисляется из пароля и почты. На новом ноутбуке получается тот же ключ, и никакого сопряжения устройств не нужно.
Конверт с подписанным заголовком. Справочник сжимается и шифруется AES-GCM. Порядок важен: шифротекст не сжимается вовсе, а JSON справочника на 5000 товаров жмётся примерно в десять раз. Версия формата и параметры вывода ключа лежат в конверте открыто, иначе через год будет нечем расшифровать. Вся открытая часть уходит в AES-GCM как additionalData. Без этого тот, кто добрался до сервера, мог бы переписать число итераций на единицу. С привязкой любая подмена ломает проверку целостности. Вектор инициализации на каждую запись свежий: повтор при одном ключе ломает GCM полностью.
Ключ, который нельзя достать. Чтобы не спрашивать пароль при каждой перезагрузке, ключ шифрования лежит в IndexedDB. Это неизвлекаемый CryptoKey: браузер умеет им шифровать, но байты не отдаст ни мне, ни чужому скрипту на странице. В localStorage так не получится: туда кладут строки, значит, ключ пришлось бы выгрузить в байты. Срок жизни — семь дней, по ритму еженедельного отчёта. Ключ стирается при выходе, по истечении срока и при ответе 401 от сервера: если сессии больше нет, ключу тоже нечего делать.
Цена решения. Забытый пароль означает потерянный справочник, восстановить его нельзя. Я проработал схему с отдельным ключом данных и ключами устройств и отказался от неё: справочник весит сотни килобайт, и перешифровать его при смене пароля дёшево. Сложность не окупалась. Попутно неверный пароль нельзя отличить от испорченных данных, в обоих случаях просто не сходится тег GCM. Поэтому текст ошибки честно называет обе причины.
Вызов 6. Как проверить парсер без чужих отчётов
Настоящий отчёт крупного продавца просто так не получить: это коммерческие данные. А даже с ним остаётся вопрос: с чем сравнивать результат? Строки «итого» в файле нет, а Excel, как мы уже видели, пропускает суммы, записанные текстом.
Ответом стал генератор синтетических отчётов. Он сочиняет продавца с каталогом, пишет файл на нужное число строк и одновременно считает правильный ответ. Генератор знает правду по построению: он сам придумал каждую строку. Такой эталон сильнее сравнения двух парсеров между собой и работает на любом объёме.
Все неприятности живого файла в генератор заложены нарочно:
- 84 колонки в порядке настоящего файла, сверенные с документацией WB отдельным скриптом;
- три заголовка написаны так, как в живых отчётах, а не как в документации;
- часть сумм записана текстом с запятой;
- уникальные на строку значения растят таблицу общих строк так же, как в жизни;
- у трети товаров несколько размеров под одним артикулом WB, чтобы ошибка в выборе ключа товара не прошла незамеченной.
Генератор детерминирован: один и тот же сид даёт один и тот же файл. Поэтому большие файлы не лежат в репозитории, их можно пересобрать в любой момент. Число товаров задаётся отдельным параметром, и именно файл с широким каталогом показал, что память растёт от числа товаров.
Поверх генератора работает бенчмарк. Он меряет время и пик памяти, а потом сравнивает результат с эталоном. Быстрый, но неверный разбор бенчмарк провалит. Парсер не знает, где его запустили: на входе всегда Blob, в браузере из зоны перетаскивания, в Node из openAsBlob. Значит, в Node измеряется ровно тот код, который поедет в браузер. Все цифры в этой статье сняты именно так, в Node 24.
Всего в проекте около 490 тестов на Vitest.
Что я из этого вынес
Штатные API браузера умеют больше, чем кажется. DecompressionStream и CompressionStream заменили библиотеку для zip, Web Crypto заменил криптографическую, IndexedDB хранит ключ, который нельзя достать. В итоге разбор XLSX, шифрование и даже выгрузка обратно в Excel обошлись без сторонних зависимостей. На сервере та же история: Node 24 запускает TypeScript без сборки, а база — встроенный node:sqlite.
Память зависит не от того, что читаешь, а от того, что держишь. Гигабайт XML проходит через парсер без следа, если не оставлять себе лишнего. Главный приём — целые числа вместо строк до самого конца.
Мерить нужно на худшем случае. На файле с 300 товарами бюджет памяти соблюдался с запасом. Проблема показалась только тогда, когда каталог стал отдельным параметром и его раскрутили до 10 000.
Честность — это тоже техническое решение. Незнакомые операции видны на дашборде, а не теряются. Товар без цены не получает придуманную прибыль. Ошибка расшифровки называет обе возможные причины. Каждое такое решение стоит несколько строк кода, а без них продавец перестал бы верить цифрам.
Кое-что пока открыто. На синтетике строка «прочее» равна нулю, что в ней окажется на живых отчётах, покажет время. К расходам без привязки к товару я вернусь, когда будет понятна их настоящая доля.
Попробовать сервис можно на statsvod.ru.